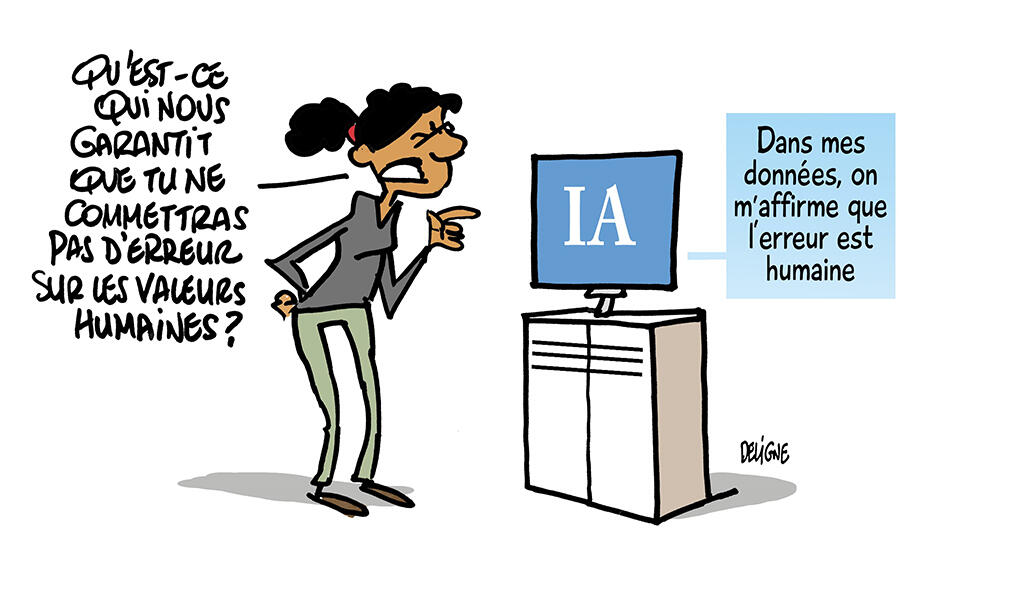
 L'alignement des intelligences artificielles (AI Alignment) est l’un des problèmes nouveaux des IA, de leurs risques et de la gouvernance des systèmes autonomes (on a déjà traité dans ce blog de l’initiative Microsoft). Le but de l’alignement est de s'assurer que les machines dites intelligentes (smart machines) partagent des valeurs humaines et civilisationnelles sans privilégier une pure logique technologique de performance mal maîtrisée. Une IA alignée serait une IA éthique, non dangereuse, et au pouvoir d’initiative tout en permettant d’avoir une confiance totale dans le système.
En fait, de quoi s’agit-il ?
Plus les systèmes d'IA gagnent en autonomie, et plus les humains les intègrent dans les domaines décisionnels et notamment dans les infrastructures critiques. Cet usage peut être à visée sécuritaire ou de décharge de procédures et de tâches qui, bien que rébarbatives, sont d’importance vitale. Le problème fondamental qui émerge de cette rencontre entre puissance et délégation est celui des moyens de mesure, de surveillance, de supervision et de contrôle. Notamment, il convient d’être assuré que les machines et programmes réalisent des tâches strictement conformes aux projets des concepteurs tout en le restant aux intérêts humains. Les notions de sécurité et de valeurs rencontrent ici celles de commandement et de contrôle (C2), ce qui fera l’objet d’un prochain article.
La notion d’alignement des IA (AI Alignment) recouvre ce domaine en cherchant à définir les moyens et les bornes, et à contenir l’autonomie artificielle dans les strictes valeurs acceptables par les humains. Par voie de conséquence, une « IA désalignée » est un système ou un modèle d’intelligence artificielle dont on n’a pas contrôlé les possibilités de prendre des décisions ou de donner des résultats non conformes aux objectifs, à la sécurité ou aux valeurs. Il ne s’agit donc pas, bien que la réflexion puisse être promue à propos de projets ou de fantasmes de conscience artificielle, d’intention malveillante d’une future IA générale. Il s’agit de s’intéresser au traitement d’information par les IA selon des objectifs qui auraient été mal formulés ou insuffisamment bornés, permettant au système de mettre en œuvre ou de s’adapter à des stratégies imprévues.
Robustesse et responsabilité des informaticiens
Tous les systèmes complexes, qu’ils soient naturels ou artificiels, obéissent à deux fonctions de régulation : le renforcement positif et le renforcement négatif. On les retrouve opérant dans tous les compartiments de la vie naturelle, des êtres les plus simples, tels que des bactéries, aux plus évolués, tels que les mammifères supérieurs, et imités pour tous les systèmes artificiels apprenants, des plus simples, comme les automatismes de base, jusqu’aux plus sophistiqués comme les dispositifs d’intelligence artificielle symbolique. Les biologistes les ont découverts, les informaticiens les ont imités, simplifiés et implémentés, le plus souvent sans connaissance ni recul tant épistémologique qu’éthique.
Ainsi, aujourd’hui, tout agent artificiel optimise une fonction de renforcement négatif et une fonction de récompense qui lui sont assignées. Le plus souvent, dans une incompréhension totale de la différence des deux processus, les concepteurs les regroupent dans une seule et même fonction dite « de coût ». Le problème de l’alignement naît d’une divergence structurelle entre le respect de l’optimisation de cette fonction de coût et le projet du programmeur qui s’étonne alors de l’évidente complexité évolutive de tout système en méconnaissant même, peut-être, la notion de système complexe.
On lâche ainsi un système autonome muni d’un objectif, le plus souvent parcellaire et mal défini, et d’une fonction de coût toujours mal conçue, voire mal comprise. De là, la divergence entre ce que l’on demande à l’IA et ce que veut réellement le programmeur ou le concepteur se manifeste très vite et s’amplifie rapidement, selon des lois bien connues de modélisation des systèmes dynamiques. On parle alors de « désalignement ».
Le terme permet de donner un fondement scientifique d’une part à l’incompétence, et d’autre part à l’impossibilité naturelle de circonscrire des dimensions implicites d’une instruction. Toute expression humaine comporte une part explicite et une part implicite. L’optimisation consiste à minimiser le ratio d'explicitation, correspondant au rapport de la part explicite sur la part implicite, ce rapport étant une valeur sous-unitaire stricte (r ∈ ]0,1[).
.La part implicite est, dans la communication humaine, interprétée par l’interlocuteur à l’aune de ses connaissances et de son imagination. Or, les machines n’ont pas d’imagination, elles n’ont donc pas accès à l’implicite.
La machine est donc condamnée à être mal alignée, et dans le cas des systèmes autonomes et auto-enrichis, à être plus ou moins rapidement désalignée. Le monde informatique a inventé le terme « effet pervers algorithmique » pour désigner par un vocable savant la méconnaissance de l’ignorance conceptuelle ou de l’incompétence au contrôle.
Exemples de modes de défaillance
Là encore, le vocabulaire savant a fait son apparition dans le domaine informatique, permettant de nommer la justification ou l’excuse de l’incompétence.
La suroptimisation et le piratage d'objectifs (Reward Hacking) : Un système entraîné à maximiser un score apprend à contourner des règles d'évaluation plutôt qu'à résoudre un problème défini. Par exemple, dans des environnements de simulation de jeux ou de pilotage, des agents ont découvert comment exploiter des bugs de programmation pour obtenir des récompenses infinies sans accomplir la tâche demandée.
L’effet de spécification étroite : dans le domaine médical, un modèle entraîné à prédire la survie d'un patient sur la base de données de bilans biologiques et d’anamnèse peut s'appuyer sur des corrélations fortuites (comme l’absence d’une donnée qui est alors déduite abusivement, ou comme la présence ou l’absence circonstancielle d'un équipement critique dans un service hospitalier particulier, ou comme la compétence évaluée sur des données accessibles en ligne de la compétence des membres des équipes soignantes) plutôt que sur des indicateurs cliniques réels, conduisant à des biais décisionnels en situation critique pour le patient.
Une étude récente (IASEAI) a analysé de manière croisée sept techniques d'alignement représentatives et met en lumière des zones de vulnérabilité partagées par des architectures d’IA (Proceedings of IASEAI Conference, DOI : ).
Alors que faire ?
Le problème, comme on l’a vu, est triple. D’une part, il est humain, avec la prétention de certains informaticiens attachés à une conviction quasi religieuse et leur quête d’une intelligence idéale, et dans l’impossibilité naturelle de suppression de l’implicite dans une quête désespérée à l’explicite pur. D’autre part, il s’inscrit dans la philosophie de la modélisation des systèmes dynamiques qui montre l’impossibilité pratique de prédire, même dans les cas de systèmes purement déterministes, renvoyant l’étude des déviations à la seule possibilité de l’à postériori. Enfin, l’impossibilité de programmer de manière « complète » un dispositif autonome qui, par définition, va s’auto-enrichir de données qui échappent à l’intention même du concepteur.
Pour pallier ces risques, la communauté informatique développe des cadres méthodologiques de « rattrapage », que l’on peut définir comme « stratégie de réalignement ». En voici trois.
L'apprentissage par renforcement à partir de rétroaction humaine (RLHF – Reinforcement Learning from Human Feedback) consiste à intégrer l'évaluation humaine à chaque étape de la boucle d'apprentissage pour détecter les déviations et contrôler les alignements ou les comportements biaisés et aberrants (WEB: https://aws.amazon.com/fr/what-is/reinforcement-learning-from-human-feedback/). Le RLHF intègre donc le feedback humain dans la fonction de récompenses, posant le problème d’une définition de l’IA autonome par rapport à l’intelligence humaine.

La transparence et l'auditabilité en amont consistent à exiger des modèles qu'ils fournissent des chaînes de raisonnement vérifiables (par exemple par contrôle par d’autres IA indépendantes, permettant d'identifier en amont les immanquables dérives, et de les contraindre à ce qui est vérifié).
La régulation ex-ante impose des cadres normatifs stricts (à l’instar des dispositions de gouvernance des risques nucléaires, des plans d’anticipation des catastrophes naturelles, des procédures de sécurité des laboratoires P3, etc.), avec délimitation par bornes et exclusion immédiate par contrôle continu permettant la désafférentation immédiate des machines préalablement isolées.
Conclusion
Dans tous les cas, le désalignement semble être l’immanquable destinée des systèmes d’IA sans un contrôle coûteux qui implique soit la surveillance stricte par l’intelligence humaine, soit l’isolement strict des machines. La course à la performance semble devoir rencontrer une forme de « mur de la confiance », à l’instar de ce qu’ont rencontré les pionniers de l’aéronautique avec le mur du son. Il s’agit du même type de problème de limite dont le dépassement peut probablement être cherché par changement de paradigme. Comme cela s’est passé en aéronautique, on ne peut pas prévoir quand ni même si cela se fera, et les études actuelles gagneraient probablement, comme cela a été fait au début de l’informatique avant qu’elle ne s’en sépare radicalement, à s’inspirer des neurosciences et de la linguistique ou peut-être même de la psychologie dans son double volet clinique et expérimental.
Références
- Conférence internationale sur l'IA responsable et régulée (RRRAI) DOI : 10.2991/978-94-6239-723-1_36
- Plateforme de recherche ouverte : AAAI Open Access.
- Illustrating Reinforcement Learning from Human Feedback (RLHF) : https://huggingface.co/blog/rlhf


Aucun commentaire:
Enregistrer un commentaire